

Развитие технологий искусственного интеллекта постепенно меняет привычные подходы к выбору персональных компьютеров для работы и разработки. В этой статье мы подробно разберем, что представляет собой современный ИИ ПК, какие аппаратные модули делают его уникальным и чем он отличается от классических систем. Мы рассмотрим ключевые конфигурации оборудования под задачи машинного обучения, локальный запуск языковых моделей и генерацию медиаконтента. Также вы найдете наглядную таблицу спецификаций и готовые сборки для комфортного входа в сферу локального AI.
Содержание
- Чем отличается обычный компьютер от ПК для AI и нейросетей
- Конфигурации ПК для задач ИИ и машинного обучения
- Спецификация оборудования под профильные ИИ-направления
- Готовые конфигурации ПК ARTLINE с нейронным процессором NPU
- Индивидуальный подбор оборудования под задачи машинного обучения в ARTLINE
Чем отличается обычный компьютер от ПК для AI и нейросетей
Вычислительные платформы для локального машинного обучения и развертывания нейросетей коренным образом отличаются от традиционных потребительских систем. Обычный ПК рассчитывает задачи последовательно или через стандартный графический рендер, тогда как специализированная станция опирается на иную архитектуру распределения ресурсов. Главным маркером современного «ИИ ПК» выступает интегрированный блок NPU (Neural Processing Unit), обеспечивающий производительность на уровне не менее 40+ TOPS по стандартам Microsoft Copilot+. Наличие такого модуля избавляет основной процессор от рутинной нагрузки при обработке алгоритмов.
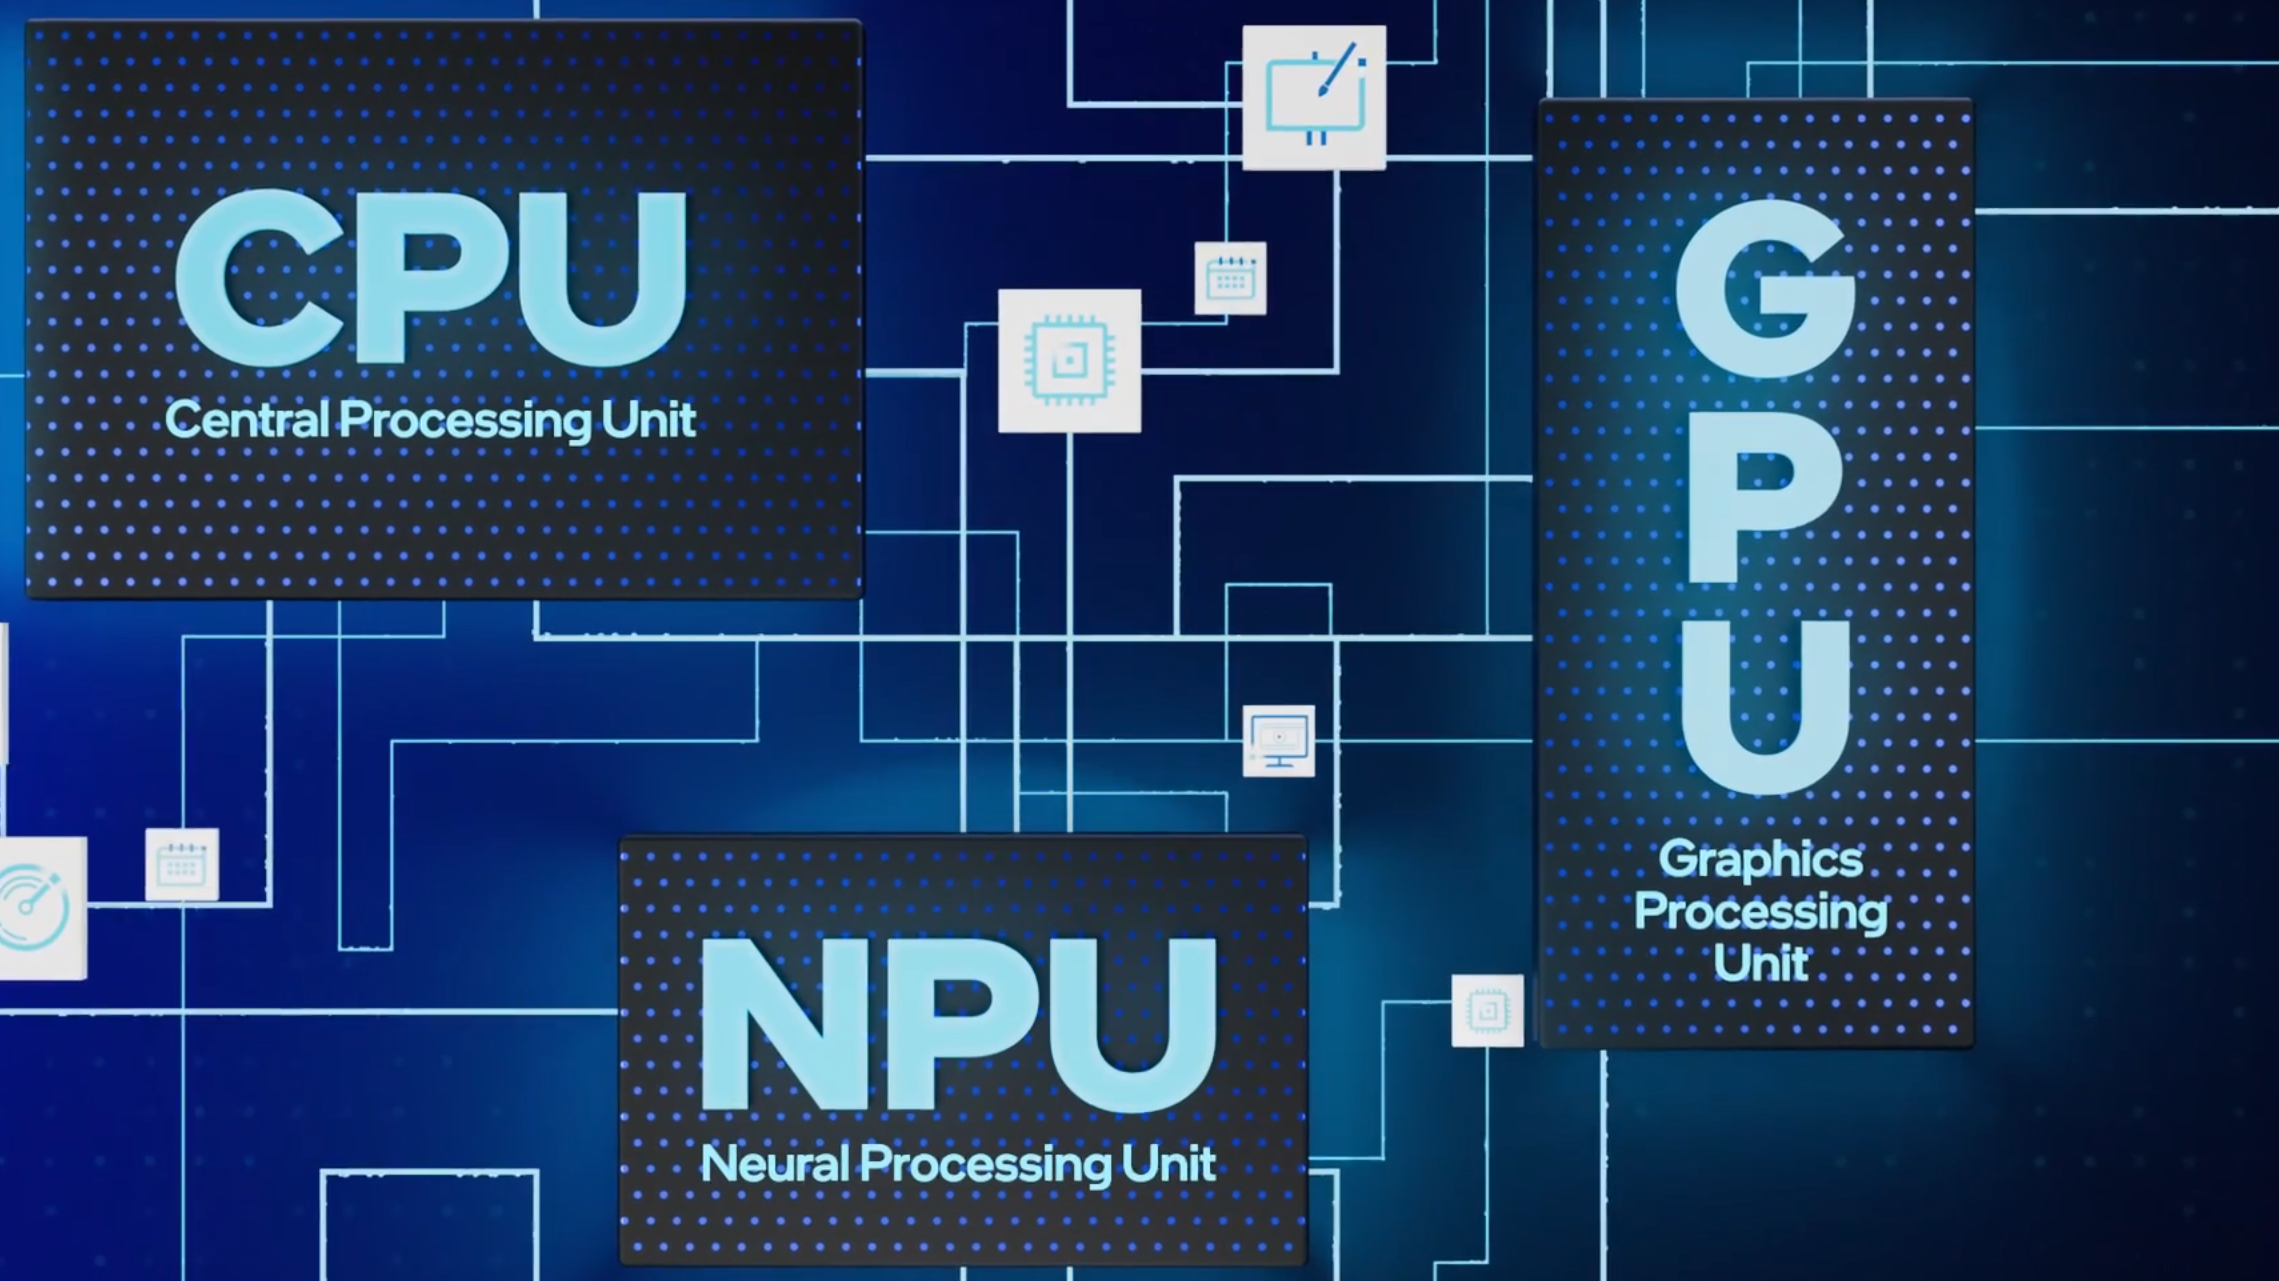
Современные рабочие станции строятся на базе трехмоторной архитектуры. Центральный процессор (CPU) управляет операционной системой, базовой логикой и сетевыми потоками. Дискретный графический адаптер (GPU) отвечает за массивные параллельные вычисления, генерацию медиаконтента и обучение сетей, но имеет высокое энергопотребление. Сопроцессор NPU забирает на себя круглосуточные фоновые операции вроде автокадрирования, шумоподавления, ведения контекстного поиска и локальной обработки текстов без нагрева процессора. Грамотная комбинация всех трех узлов позволяет достичь максимального КПД при сложных вычислениях.
Локальный запуск нейросетей формирует так называемый «налог на память», поскольку вес весов и тензоров исчисляется десятками гигабайт. Базовым стандартом для таких систем становятся 16 ГБ ОЗУ, а профессиональная аналитика требует от 32 до 128+ ГБ системной памяти. Системное перенаправление фоновых алгоритмов на NPU снижает расход энергии десктопов и ноутбуков на 30–40% при сессиях видеосвязи с ИИ-эффектами.
Локальное развертывание больших языковых моделей (LLM) гарантирует полную конфиденциальность данных, исключая их отправку на облачные сервисы. Это особенно критично для корпоративных клиентов и исследовательских групп. Если вы хотите детально разобраться в аппаратных решениях промышленного масштаба, читайте в нашей статье «ИИ сервера: обзор архитектуры и ключевых решений для машинного обучения».
Конфигурации ПК для задач ИИ и машинного обучения
Выбор комплектующих строго привязан к специфике работы: простые генеративные сценарии требуют объемистой видеопамяти, а обучение глубоких моделей нагружает все узлы. Ошибка в подборе платформы часто приводит к критическим задержкам при обработке входных тензоров. Ниже мы разделили вычислительные платформы на три профильные категории под конкретные профессиональные задачи. Внимательно оцените масштабы ваших проектов перед покупкой железа.
Минимальная конфигурация (локальный инференс, прототипирование и базовая разработка)
Базовый уровень позволяет разворачивать оптимизированные квантованные модели, редактировать графику с помощью нейросетей и вести первичную разработку код-базы. Система рассчитана на локальную отладку без переплат за серверный класс комплектующих. Вся база опирается на доступные потребительские компоненты нового поколения.
- Процессор (CPU): Многоядерный чип текущего поколения или SoC с обязательным интегрированным блоком NPU производительностью от 40+ TOPS.
- Видеокарта (GPU): Дискретный адаптер с 8-16 ГБ видеопамяти VRAM либо мощное гибридное графическое ядро с динамическим выделением ресурсов.
- Оперативная память (RAM): От 16 до 32 ГБ скоростной ОЗУ для предсказуемой работы без обращения к файлу подкачки.
- Накопитель: Твердотельный модуль NVMe SSD на 1 ТБ для быстрого считывания дистрибутивов и весов.
Чтобы избежать перегрева процессора при длительном разгоне, рекомендуем обратить внимание на состав интерфейсов охлаждения. Некачественный теплосъемник приводит к сбросу частот в самый ответственный момент выполнения задачи. Подробнее о подборе состава читайте в нашей статье про то, как выбрать термопасту (типы, характеристики и создание эффективного охлаждения).
Для эффективного запуска нейросетей ключевую роль играет однопоточная выносливость вычислительных кристаллов. Чипсет с высоким объемом кэш-памяти ощутимо ускоряет компиляцию кода и предобработку массивов. Выбрать чип с нужным количеством ядер вы можете в нашем профильном каталоге.
Средняя/рекомендуемая конфигурация (инференс локальных LLM, Data Science и аналитика)
Оптимальный сетап для работы с фреймворками PyTorch и TensorFlow, обработки крупных датасетов и автономного запуска языковых моделей уровня 7B-14B+. Конфигурация предотвращает кадровые просадки при параллельных вычислительных процессах. Она идеально подойдет как практикующим дата-сайентистам, так и независимым разработчикам ПО.
- Процессор (CPU): Многоядерный ЦП для эффективного распараллеливания операций предварительной очистки и трансформации данных.
- Видеокарта (GPU): Графический ускоритель с 16-24 ГБ VRAM и большим количеством ядер CUDA.
- Оперативная память (RAM): 64-128 ГБ системной ОЗУ для размещения объемистых библиотек в памяти.
- Накопитель: Высокоскоростной NVMe SSD объемом от 2 ТБ под объемные библиотеки и файлы проектов.
Оперативная память высокой частоты критична при обработке больших языковых моделей, полностью загружаемых в RAM. Недостаток объема приводит к резкому снижению скорости токенизации и обработки запросов. Подобрать быстродействующий комплект оперативной памяти под вашу систему можно в специальном разделе.
Максимальная/топовая конфигурация (обучение крупномасштабных моделей и Multi-GPU)
Бескомпромиссное решение для глубокого обучения (Fine-Tuning), обработки миллионных датасетов и непрерывного конвейерного инференса. Конфигурация собирается с расчетом на круглосуточные предельные нагрузки без просадок по питанию и охлаждению. Такой уровень мощностей закрывает потребности исследовательских лабораторий и R&D-отделов.
- Процессор (CPU): Многоядерный процессор класса Workstation для исключения узких мест при подаче тензорных потоков.
- Видеокарта (GPU): Конфигурация из нескольких профессиональных ускорителей (Multi-GPU) с суммарным объемом VRAM от 24 ГБ на каждый адаптер.
- Оперативная память (RAM): 128-256 ГБ+ системной памяти.
- Накопитель: Массив NVMe SSD емкостью от 2-4 ТБ+ под чекпоинты и сырые структуры.
Большой объем VRAM является ключевым условием для удержания сложных архитектур в памяти видеокарты. Профессиональные адаптеры обеспечивают стабильность вычислений за счет специализированного ПО и отказоустойчивых драйверов. Подобрать мощную видеокарту под задачи ИИ можно прямо в нашем каталоге.
Твердотельные накопители с поддержкой стандарта PCIe 4.0 и 5.0 гарантируют мгновенную загрузку массивных моделей в видеопамять. Они исключают подвисания системы при частой перезаписи контрольных точек обучения. Выбрать надежный SSD большого объема вы можете на нашем сайте.
Спецификация оборудования под профильные ИИ-направления
Различные задачи в сфере машинного обучения задействуют аппаратные ресурсы с разной степенью интенсивности. Четкая сбалансированность подсистем предотвращает ситуации, когда дорогая видеокарта простаивает из-за слабой оперативной памяти. В таблице ниже систематизированы требования к ключевым узлам системы в зависимости от вашего рабочего профиля.
|
Направление/Задача |
Процессор (CPU/NPU) |
Видеокарта (GPU/VRAM) |
Оперативная память (RAM) |
Накопитель (Storage) |
Ключевые акценты и архитектура |
|
Генерация медиа (Изображения, Аудио, Видео) |
Многоядерный ЦП для сценариев; NPU для локального редактирования и фонового уплотнения |
Дискретный GPU с высокой пропускной способностью и 16–24 ГБ VRAM |
64-128 ГБ RAM |
Скоростной NVMe SSD |
Пиковые нагрузки обработки графики берет на себя GPU, а фоновую оптимизацию и маскирование – NPU |
|
Локальные LLM/Инференс |
Совместимый ЦП; NPU (40+ TOPS) для локального офлайн-запуска оптимизированных моделей без отправки данных в облако |
GPU с VRAM от 16 ГБ до 24 ГБ для удержания параметров нейросети в памяти |
64-128 ГБ RAM (для профессиональных задач – от 128 ГБ) |
Скоростной NVMe SSD для быстрой подгрузки моделей |
Нагрузка сфокусирована на объеме VRAM и ОЗУ; инференс создает меньшую нагрузку на ЦП, чем обучение |
|
Обучение ИИ-моделей (AI Model Training) |
Мощный многоядерный ЦП рабочих станций для устранения узких мест при конвейерной обработке |
Мощный GPU с высоким числом ядер CUDA и от 24 ГБ VRAM (или Multi-GPU) |
Базовый уровень – 128 ГБ RAM (для гигантских массивов – 256 ГБ+) |
Скоростной NVMe SSD от 2 ТБ+ для датасетов и чекпоинтов |
Наиболее ресурсоемкая нагрузка, требующая непрерывных вычислений и масштабируемых систем |
|
Работа с датасетами (Data Science) |
Высокопроизводительный многоядерный ЦП для параллельного анализа и очистки данных |
GPU-ускорение для визуализации и исследовательского моделирования |
64-128 ГБ RAM (при масштабных датасетах – 256 ГБ+) |
Скоростной NVMe SSD для ускорения чтения и трансформации данных |
Нагрузка ложится преимущественно на ЦП и системную память, а не на графический чип |
|
Профессиональные задачи (Pro AI Workflows) |
Трехмоторная гибридная схема: ЦП (ОС и логика), NPU от 40+ TOPS (фоновое ИИ), GPU (тяжелая графика) |
Дискретный GPU для тяжелой графики или NPU для фоновых видеоэффектов |
Базовый минимум – 16-32 ГБ RAM (для рабочих станций – 64 ГБ+) |
Высокоскоростной NVMe SSD |
NPU экономит 30-40% энергии при видеоконференциях и выполняет фоновые задачи без шума и нагрева |
Качественное отображение многооконных интерфейсов и графических метаданных существенно упрощает аналитическую работу. Высокая плотность пикселей и точная цветопередача снижают утомляемость глаз при длительном написании кода. Подобрать профессиональный монитор под требования САПР и ML вы можете в каталоге.
Готовые конфигурации ПК ARTLINE с нейронным процессором NPU
Для гарантированной стабильности и исключения аппаратных конфликтов инженеры ARTLINE разработали линейку готовых платформ. Каждая система построена на базе свежих чипов Intel Core Ultra со встроенным сопроцессором NPU и прошла комплексные стресс-тесты в реальных алгоритмах. Вам остается подобрать решение под текущий объем вычислений.
Минимум для работы с ИИ 2026
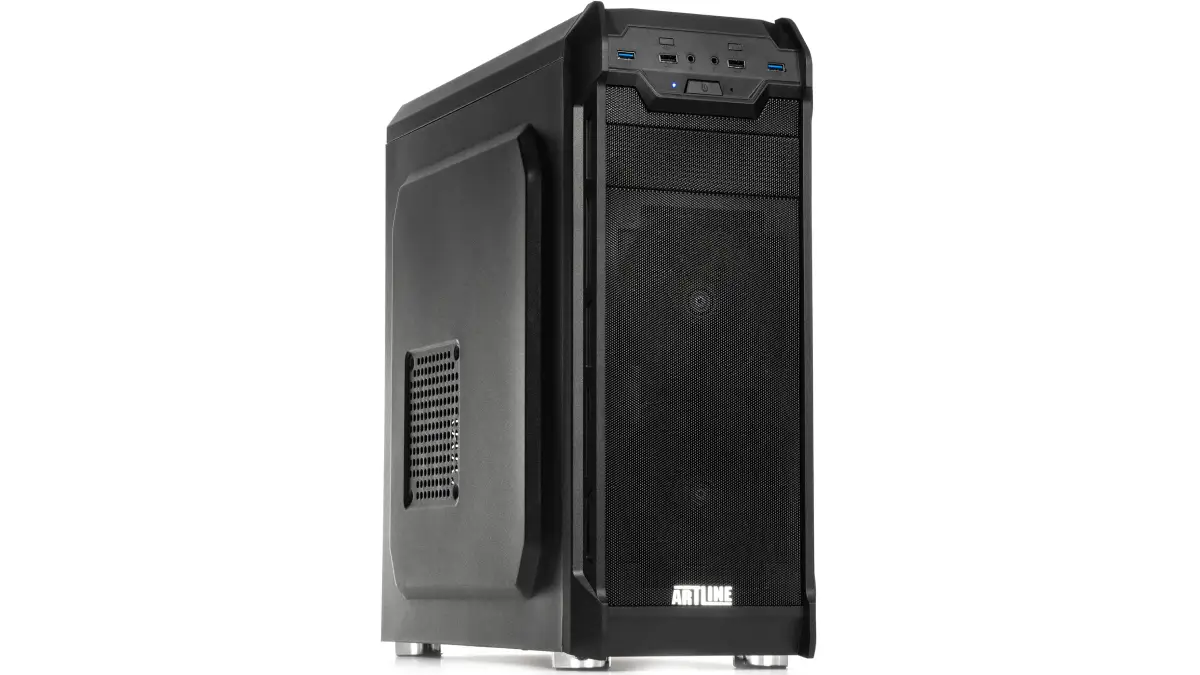
ARTLINE WorkStation W53 – начальная станция для эффективной автоматизации рутинных процессов, работы с Copilot+ и локального прототипирования нетребовательных моделей. В основе лежит процессор Intel Core Ultra 5 235 со встроенным блоком NPU, работающий в паре с графикой GeForce RTX 5060 8GB (или RTX 4060) и 32 ГБ ОЗУ DDR5. Под управлением скоростного SSD на 1 ТБ NVMe Gen4 фоновые задачи обрабатываются на NPU без шума, нагрева и привлечения основного GPU. Это сбалансированное решение для быстрого входа в сферу разработки.
Средняя/рекомендуемая конфигурация от Артлайн
Мощный комплекс для автономии при запуске текстовых моделей размера 7B-14B+, ускоренной генерации графики и комфортного анализа массивов. Модель ARTLINE SAMURAI 3.0 оснащена 20-ядерным процессором Intel Core Ultra 7 265KF с блоком NPU, 96 ГБ DDR5-6400 и топовой видеокартой GeForce RTX 5080 16GB. Накопитель емкостью 2 ТБ NVMe Gen4 с легкостью вмещает рабочие библиотеки PyTorch и TensorFlow. Платформа рассчитана на длительные сессии непрерывных математических расчетов.
Максимальная/топовая рабочая станция для AI
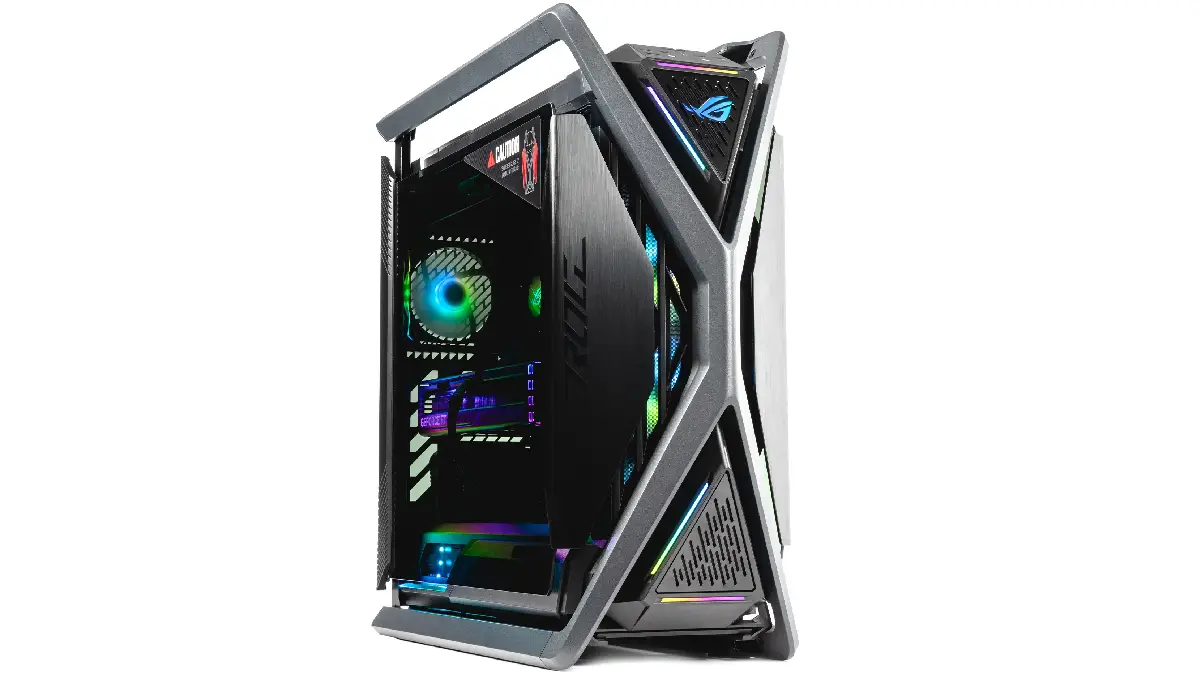
Флагманская платформа ARTLINE Overlord HYPERION, спроектированная под задачи тонкой настройки и глубокого обучения нейросетей. «Сердцем» выступает 24-ядерный Intel Core Ultra 9 285K с NPU, дополненный видеокартой GeForce RTX 5090 с 32 ГБ VRAM, 96-128 ГБ+ DDR5-6400 и комбинированным SSD-массивом на 4 ТБ (Gen5 + Gen4). Мощности 32 ГБ видеопамяти достаточно для удерживания монументальных нейросетей в едином графическом пространстве без сужения шины. Системный блок готов к максимальным нагрузкам прямо из коробки.
Индивидуальный подбор оборудования под задачи машинного обучения в ARTLINE
Если ваша специфика требует точной подгонки параметров, сборка уникального системного блока под требования ИИ реализуется инженерами ARTLINE по вашему техзаданию. Вы можете воспользоваться нашим интеллектуальным AI-помощником, который за секунды проанализирует входящие задачи и предложит идеальный баланс комплектующих. Грамотно собранная конфигурация позволит сэкономить бюджет и избежать переплат за ненужные узлы.
Мы учитываем тип разворачиваемых библиотек, вес используемых датасетов и доступный финансовый лимит. Каждая готовая станция проходит предпродажное тестирование в специализированных бенчмарках. На всю технику поставляется официальная гарантия с последующим техническим сопровождением.
г. Киев, ул. Кирилловская, 104
- (080) 033-10-06
- (044) 338-10-06
- (066) 356-10-01
- (097) 356-10-01
- (063) 356-10-01